Sua consulta RAG parece lenta. Você olha para o tempo de resposta do modelo e assume que é o modelo o culpado, afinal, geração de texto leva segundos. Mas quando você começa a medir cada componente separadamente, descobre que a rede está contribuindo com uma fatia relevante da latência total, e essa fatia pode ser otimizada.
Por que latência de rede importa num pipeline que já é “lento por natureza”
Um pipeline RAG típico soma a latência de várias etapas em sequência: geração de embedding da pergunta, busca híbrida no índice, reordenação semântica e geração da resposta pelo modelo.
É tentador assumir que a geração do modelo domina o tempo total, afinal, o modelo pode levar segundos dependendo do tamanho da resposta, e ignorar a rede como fator secundário. Na prática, quando a arquitetura está mal desenhada em termos de região e conectividade, a rede pode adicionar centenas de milissegundos em saltos que deveriam ser desprezíveis.
O problema não é que a rede vai dominar o tempo total, provavelmente não vai. O problema é que latência de rede mal desenhada é variável e imprevisível, e soma variação a um componente que já varia: em deployments Standard e Global Standard, o próprio tempo do modelo oscila com a carga do serviço, e só o provisionado (PTU) tem latência previsível. Picos dos dois lados transformam um P99 aceitável num P99 inaceitável para usuários.
Os quatro saltos de rede de uma consulta RAG
Uma consulta RAG típica com agente no Microsoft Foundry, Azure AI Search e Azure OpenAI tem a seguinte sequência de chamadas de rede:
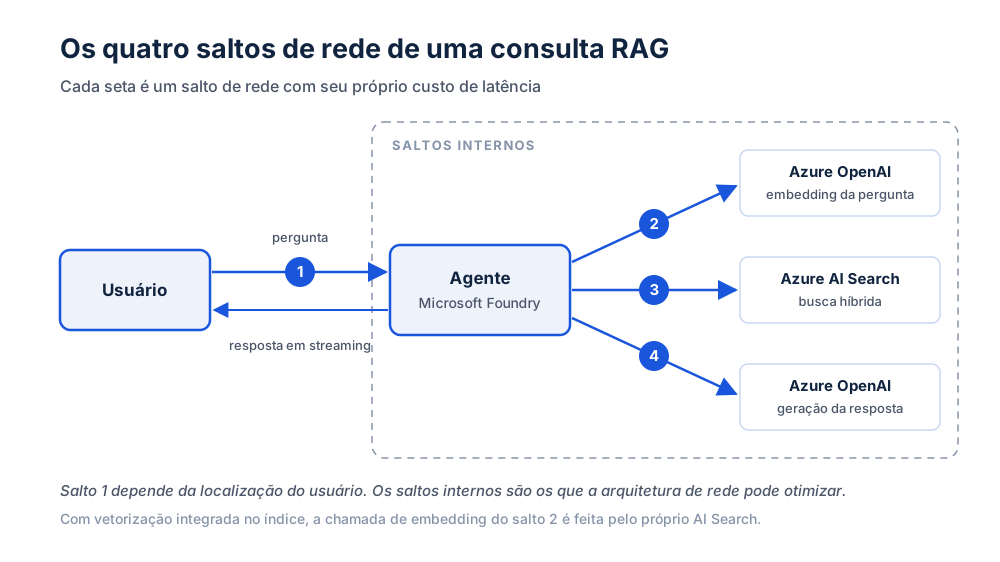
Usuário → Agente (Foundry) → Azure OpenAI (embedding) → [vetor da pergunta]
                           → Azure AI Search          → [resultado da busca]
                           → Azure OpenAI (geração)   → [resposta gerada]
                           → Usuário
Cada seta é um salto de rede com seu próprio custo de latência:
Salto 1: Usuário → Agente. Latência determinada pela localização do usuário e do endpoint do agente. Geralmente o maior salto para usuários no Brasil acessando endpoints em regiões americanas.
Salto 2: Agente → Azure OpenAI, para gerar o embedding da pergunta com o modelo de embedding. (Se o índice usa vetorização integrada, quem faz essa chamada é o próprio AI Search.)
Salto 3: Agente → Azure AI Search. A busca híbrida com o vetor da pergunta. Deve ser intra-região ou via Private Link para minimizar latência.
Salto 4: Agente → Azure OpenAI, a chamada de geração, com a resposta voltando em streaming para o usuário. Latência dominada pelo tempo de inferência do modelo, mas com overhead de rede significativo se os recursos estiverem em regiões diferentes.
Os saltos internos, Agente ↔ OpenAI e Agente ↔ Search, são os que a arquitetura de rede pode e deve otimizar. Os saltos externos dependem da localização do usuário.
Fator 1: região dos recursos
O erro mais comum e mais caro: o agente em uma região, Azure AI Search em outra, Azure OpenAI em uma terceira.
Cada chamada entre serviços em regiões diferentes atravessa a backbone da Microsoft, o que é mais rápido que internet pública, mas ainda adiciona latência proporcional à distância geográfica.
A regra é simples: todos os componentes do pipeline RAG devem estar na mesma região.
# Verificar regiões dos recursos do seu pipeline
az resource list \
  --query "[?contains(type, 'Microsoft.Search') || contains(type, 'Microsoft.CognitiveServices') || contains(type, 'Microsoft.MachineLearningServices')].{Nome:name, Tipo:type, Regiao:location}" \
  --output table
Se os resultados mostrarem regiões diferentes, você tem um problema de latência arquitetural que nenhuma otimização de código vai resolver completamente.
Para o Brasil: Brazil South tem disponibilidade limitada de modelos no deployment regional, e regiões populares nos Estados Unidos, como East US, costumam ter capacidade disputada. Duas saídas comuns: deployments Global Standard ou Data Zone Standard, que distribuem o processamento e têm mais capacidade (se o requisito de residência de dados permitir), ou agente, Search e modelo juntos numa mesma região fora do Brasil. Nesse segundo caso, o Azure Front Door ajuda a encurtar o caminho do usuário até lá, porque recebe a conexão na borda mais próxima e segue pela rede da Microsoft. O Traffic Manager não serve para isso: ele só responde DNS e não carrega o tráfego.
Fator 2: Private Link vs. endpoint público
Aqui está o ponto contraintuitivo que mais gera debate: tráfego via Private Link não é automaticamente mais rápido que via endpoint público.
A rota interna da Microsoft entre um Private Endpoint e o serviço de destino dentro da mesma região é essencialmente a mesma, a latência de backbone intra-região é muito baixa em ambos os casos.
O ganho do Private Link está em previsibilidade e ausência de saltos por proxies/firewalls de saída para internet, que sim adicionam latência variável. Se seu agente faz chamadas para Azure AI Search via endpoint público e o tráfego passa por um Azure Firewall ou NAT Gateway, você está adicionando um salto desnecessário com latência variável.
Com Private Endpoints:
# Criar Private Endpoint para Azure AI Search
az network private-endpoint create \
  --resource-group rg-spoke-ia \
  --name pe-search \
  --vnet-name vnet-spoke \
  --subnet snet-private-endpoints \
  --private-connection-resource-id $(az search service show --name meu-search --resource-group rg-ia --query id -o tsv) \
  --group-id searchService \
  --connection-name pec-search

# Criar Private Endpoint para Azure OpenAI
az network private-endpoint create \
  --resource-group rg-spoke-ia \
  --name pe-openai \
  --vnet-name vnet-spoke \
  --subnet snet-private-endpoints \
  --private-connection-resource-id $(az cognitiveservices account show --name meu-openai --resource-group rg-ia --query id -o tsv) \
  --group-id account \
  --connection-name pec-openai
O benefício real do Private Link no contexto de latência não é velocidade bruta, é eliminação de variabilidade causada por saltos de firewall e consistência de rota.
Fator 3: Semantic Ranker adiciona uma chamada, não elimina
O Semantic Ranker do Azure AI Search melhora a relevância dos resultados, ele reordena os documentos candidatos usando um modelo de linguagem para entender o significado semântico, não só palavras-chave.
O que pouca documentação deixa claro: o Semantic Ranker é uma etapa de processamento adicional dentro do próprio serviço de Search, não um substituto para a busca vetorial ou híbrida. Ele adiciona latência à chamada de Search, não reduz.
Em termos práticos, habilitar Semantic Ranker em um índice grande com muitos candidatos pode adicionar 100-300ms à chamada de Search. Para pipelines onde latência é crítica, a decisão de usar Semantic Ranker é um trade-off entre qualidade de resposta e velocidade.
Como medir o impacto isolado do Semantic Ranker:
import time
from azure.search.documents import SearchClient
from azure.search.documents.models import QueryType

# Sem Semantic Ranker (busca só por texto, BM25)
start = time.perf_counter()
results_bm25 = client.search(
    search_text=query,
    query_type=QueryType.SIMPLE,
    top=5
)
list(results_bm25)  # Materializar resultados
t_bm25 = time.perf_counter() - start

# Com Semantic Ranker
start = time.perf_counter()
results_semantic = client.search(
    search_text=query,
    query_type=QueryType.SEMANTIC,
    semantic_configuration_name="minha-config",
    top=5
)
list(results_semantic)
t_semantic = time.perf_counter() - start

print(f"BM25: {t_bm25*1000:.0f}ms")
print(f"Semantic Ranker: {t_semantic*1000:.0f}ms")
print(f"Overhead do Semantic Ranker: {(t_semantic-t_bm25)*1000:.0f}ms")
Execute esse benchmark em horários diferentes, o Semantic Ranker usa capacidade compartilhada e a latência pode variar conforme a carga do serviço.
Como medir os saltos separadamente
Antes de otimizar qualquer coisa, meça cada componente isoladamente:
import time
from opentelemetry import trace

tracer = trace.get_tracer(__name__)

async def rag_query_with_tracing(query: str) -> dict:
    timings = {}

    # Salto 2: embedding da pergunta (Azure OpenAI)
    with tracer.start_as_current_span("embedding"):
        start = time.perf_counter()
        embedding = await get_embedding(query)
        timings["embedding_ms"] = (time.perf_counter() - start) * 1000

    # Salto 3: busca no AI Search
    with tracer.start_as_current_span("search"):
        start = time.perf_counter()
        docs = await search_documents(query, embedding)
        timings["search_ms"] = (time.perf_counter() - start) * 1000

    # Salto 4: geração com Azure OpenAI
    with tracer.start_as_current_span("generation"):
        start = time.perf_counter()
        response = await generate_response(query, docs)
        timings["generation_ms"] = (time.perf_counter() - start) * 1000

    timings["total_ms"] = sum(timings.values())
    return {"response": response, "timings": timings}
Envie esses dados para o Application Insights e monitore o P50, P90 e P99 de cada componente separadamente. A distribuição vai mostrar onde está a variabilidade, e se ela vem da rede ou do modelo.
O que fica
Os três fatores de rede que mais pesam na latência de um pipeline RAG, a região dos recursos, o caminho até os serviços e o custo do Semantic Ranker, têm soluções diretas. Mas nenhuma delas deve ser aplicada antes de medir cada salto separadamente, porque a solução para um problema de rede é completamente diferente da solução para um problema de modelo.
Se o seu assistente ficasse lento amanhã, você saberia dizer em qual dos quatro saltos o tempo foi parar?