O Private Endpoint está criado. O IP privado está certo. O acesso público ao Azure OpenAI foi desligado, como manda a boa prática. E a aplicação devolve 403, ou fica esperando até dar timeout.
Esse era o cenário de um time que passou uma tarde inteira revisando NSG, rota e firewall. Não era nada disso. O nome do serviço resolvia para o IP público, que estava bloqueado. A chamada nem chegava perto do Private Endpoint.
É o tipo de incidente que dura horas porque as pessoas olham para a rede quando o problema é DNS. Em arquitetura de IA, isso se multiplica: Azure OpenAI, AI Search e Storage, cada um com o seu Private Endpoint e a sua zona, e uma aplicação que precisa alcançar todos.
Por que IA multiplica o problema
Um pipeline RAG típico tem pelo menos três serviços privados, cada um com a sua zona Private DNS:
| Serviço | Zona privada | Zona pública para encaminhar |
|---|---|---|
| Azure OpenAI | privatelink.openai.azure.com | openai.azure.com |
| Microsoft Foundry (AI Services) | privatelink.cognitiveservices.azure.com e privatelink.services.ai.azure.com | cognitiveservices.azure.com e services.ai.azure.com |
| Azure AI Search | privatelink.search.windows.net | search.windows.net |
| Blob Storage | privatelink.blob.core.windows.net | blob.core.windows.net |
Some a isso os ambientes (desenvolvimento, homologação, produção) e os spokes de cada time. A chance de um erro de DNS cresce com o número de Private Endpoints, e ele sempre aparece como “a rede não funciona”.
Antes dos erros, a regra que evita a maioria deles: todas as zonas privatelink ficam vinculadas ao hub, onde está o Private DNS Resolver, e todo mundo pergunta ao resolver. Como montar isso está no artigo sobre Private DNS Resolver. Aqui o foco é o que dá errado.
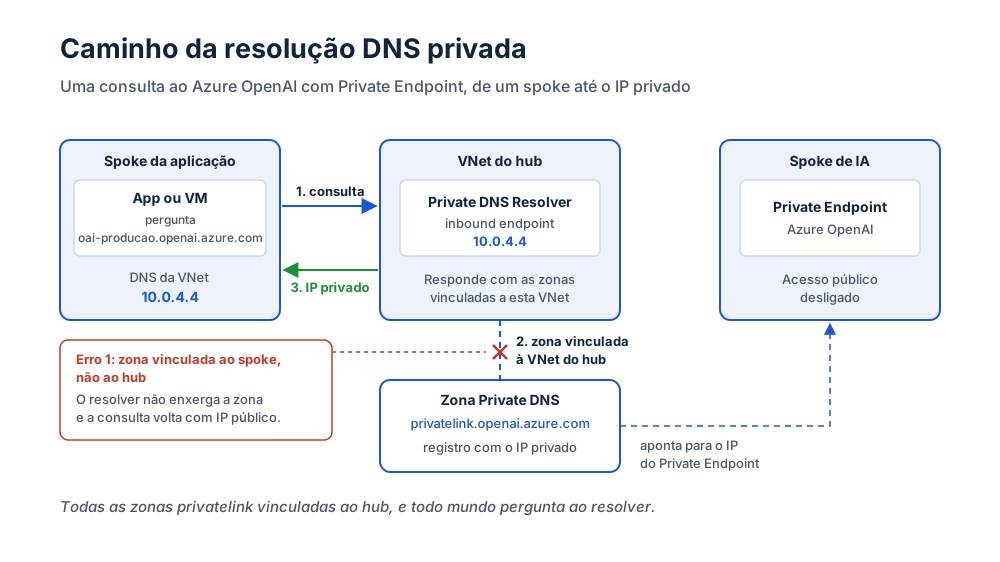
Erro 1: zona vinculada ao spoke, não ao hub
O mais frequente. O Private Endpoint nasce no spoke de IA, a zona é criada e vinculada a esse spoke. Dali, tudo funciona.
Quando a aplicação está em outro spoke, ou quando o on-premises tenta acessar, a resolução devolve o IP público. O resolver no hub responde com base nas zonas vinculadas à VNet dele, e essa zona não está lá.
# A VNet do hub costuma estar em outro resource group: use o ID completo
az network private-dns link vnet create \
  --resource-group rg-dns \
  --zone-name "privatelink.openai.azure.com" \
  --name link-hub \
  --virtual-network "/subscriptions/<sub>/resourceGroups/rg-hub/providers/Microsoft.Network/virtualNetworks/vnet-hub" \
  --registration-enabled false
Erro 2: a zona duplicada que ninguém vê
Esse é o mais traiçoeiro. Ao criar um Private Endpoint pelo portal, a opção de integrar com uma zona Private DNS vem marcada. Se o time escolhe criar a zona no próprio resource group, nasce uma segunda privatelink.openai.azure.com, com o registro do endpoint novo, vinculada só ao spoke daquele time.
A zona central, no hub, nunca recebe esse registro. Para quem consulta pelo resolver, o endpoint novo simplesmente não existe.
O sintoma é confuso: os endpoints antigos resolvem, o novo não. A correção é mover o registro para a zona central e apagar a duplicada. A prevenção são duas Azure Policies, no padrão que a Microsoft documenta para Private Link em escala: uma com efeito DeployIfNotExists por serviço, que registra cada Private Endpoint novo na zona central, e outra com efeito Deny, que bloqueia a criação de zonas privatelink fora do resource group de DNS.
Erro 3: a VNet de integração do App Service sem o DNS certo
Com VNet Integration, o App Service passa a usar a configuração de DNS da VNet onde está integrado. Não precisa de configuração extra no app. O WEBSITE_DNS_SERVER, que muita gente ainda coloca por costume, só serve para sobrescrever o DNS da VNet.
O erro, então, está na VNet. Se a sub-rede de integração fica num spoke que usa o DNS padrão do Azure e não tem a zona vinculada, o app resolve o nome público. A correção é a mesma de qualquer spoke: apontar o DNS da VNet para o inbound endpoint do resolver, ou vincular a zona.
az network vnet update \
  --resource-group rg-spoke-ia \
  --name vnet-spoke-ia \
  --dns-servers 10.0.4.4
Se o app realmente precisar de um DNS diferente do da VNet, o caminho atual é a propriedade dnsConfiguration do site, que aceita até cinco servidores e tem precedência sobre as app settings.
Erro 4: o DNS mudou, mas as máquinas não ficaram sabendo
Você corrigiu o DNS da VNet e nada mudou. VMs recebem o servidor DNS pelo DHCP, e só pegam o valor novo quando renovam a configuração, o que na prática significa reiniciar.
No AKS, isso vale para os nós: o CoreDNS encaminha para o DNS configurado no nó. Depois de mudar o DNS da VNet de um cluster, os nós precisam pegar a configuração nova (reinício controlado por pool ou node image upgrade) e os pods do CoreDNS precisam ser reiniciados em seguida. Só um dos dois não resolve.
# Depois que os nós já usam o DNS novo, reinicie o CoreDNS
kubectl -n kube-system rollout restart deployment coredns
Roteiro de diagnóstico em cinco minutos
De dentro de uma VM ou de um pod no mesmo spoke da aplicação, nunca do seu computador nem do Cloud Shell, que estão em outra rede:
# 1. O que a aplicação enxerga, com o DNS configurado na VNet
nslookup oai-producao.openai.azure.com

# 2. O que o resolver do hub responde
nslookup oai-producao.openai.azure.com 10.0.4.4
A leitura é direta:
Os dois devolvem IP privado: o DNS está certo. O problema é de rota, NSG ou firewall.
O primeiro devolve público e o segundo privado: a VNet da aplicação não está usando o resolver (erros 3 e 4).
Os dois devolvem público: a zona não está vinculada ao hub (erro 1).
A resposta traz o CNAME privatelink e termina em “Non-existent domain”: a zona central existe e está vinculada, mas não tem o registro desse recurso, que provavelmente foi parar numa zona duplicada (erro 2). Se o vínculo da zona estiver com o fallback para a internet ligado, esse caso devolve o IP público e se confunde com o erro 1.
O que fica
Quase todo incidente de “Private Endpoint não funciona” em arquitetura de IA é DNS. Antes de abrir o NSG, o firewall ou a tabela de rotas, rode os dois nslookup. Leva um minuto e diz em qual metade do problema você está.
No seu ambiente, quem garante hoje que um Private Endpoint novo não cria uma zona duplicada?