Quantas VNets isoladas de IA já existem na sua empresa? Se a resposta for “mais de uma”, este artigo é para você.
Quando um time começa a desenhar a rede para uma plataforma de agentes de IA, a tendência natural é criar uma VNet isolada só para IA e conectá-la ao resto da empresa via peering direto. Funciona no piloto. Mas quebra a governança assim que a segunda, terceira e quarta squad de IA aparecem, cada uma criando sua própria VNet, seu próprio firewall, suas próprias regras de saída para a internet.
Por que a topologia “óbvia” costuma estar errada
A topologia óbvia para quem está começando com IA generativa no Azure:
VNet-IA ──── peering ──── VNet-Corporativa ──── on-premises
Funciona bem para o primeiro projeto. O problema aparece quando o segundo time de IA começa:
VNet-IA-RH       ──┐
VNet-IA-Juridico ──┤── peering direto ──── VNet-Corporativa
VNet-IA-Finance  ──┘
Cada VNet tem seu próprio Azure Firewall (ou não tem), suas próprias regras de NSG, seus próprios Private Endpoints para os mesmos serviços (Azure OpenAI, AI Search), sua própria saída para internet, para pacotes e APIs externas. O custo de infraestrutura multiplica, a governança fragmenta, e auditar quem acessa o quê vira um pesadelo.
Onde cada componente entra na topologia hub-and-spoke
O padrão correto é tratar workloads de IA generativa como qualquer outro spoke, conectado a um hub central que concentra os recursos compartilhados:
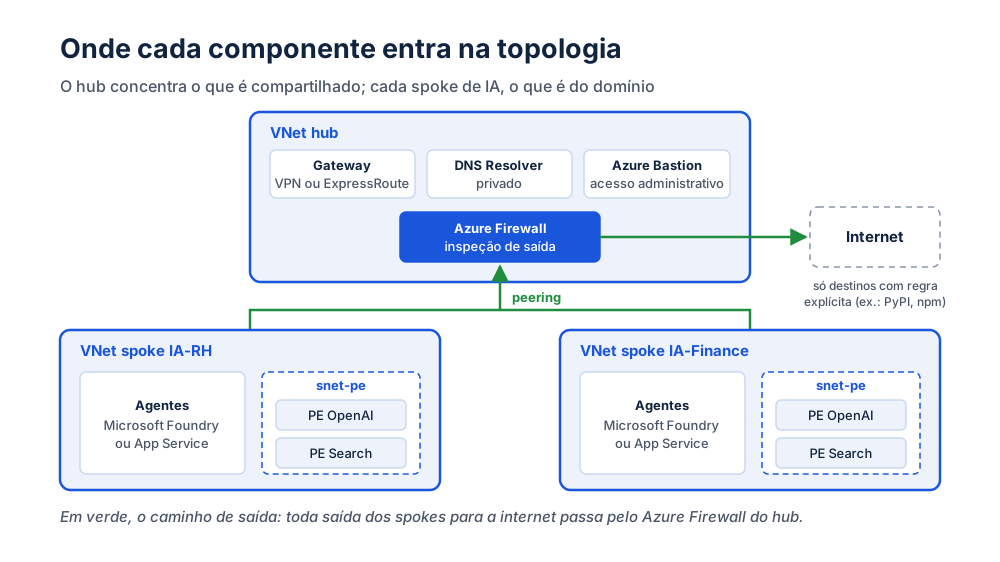
O hub concentra o que é compartilhado: o Azure Firewall (ou NVA de terceiros) para inspeção de saída, o gateway de conectividade híbrida (VPN ou ExpressRoute), o DNS Resolver privado e o Azure Bastion para acesso administrativo seguro.
Cada spoke de IA concentra o que é específico do domínio: os agentes no Microsoft Foundry (antigo Azure AI Foundry) ou App Service, os Private Endpoints para os serviços PaaS do domínio (cada spoke tem seus próprios PEs, não compartilhados entre domínios por questão de isolamento de dados), e os NSGs específicos do workload.
Regras de saída que a maioria esquece
Diferente de uma carga de trabalho tradicional, um spoke de IA generativa frequentemente precisa de saída controlada para:
- Azure OpenAI endpoints, se o recurso está no próprio spoke, o tráfego é interno. Se está em outro spoke ou hub, passa pelo firewall
- Modelos do Foundry, os modelos implantados no recurso Foundry (endpoints
*.services.ai.azure.com,*.cognitiveservices.azure.come*.openai.azure.com) são acessados pelo Private Endpoint do recurso, sem saída para internet. Liberar esses domínios para a internet no firewall contradiz o desenho privado - Repositórios de pacotes, durante build e atualização de containers (PyPI, npm, MCR)
- GitHub Copilot / APIs externas, quando agentes chamam ferramentas externas
Em VNets criadas com versões de API lançadas depois de 31 de março de 2026, as sub-redes já nascem privadas, sem a saída implícita para a internet. Com o firewall no hub, isso deixa de ser surpresa e vira desenho: toda saída passa por ele.
No Azure Firewall do hub, você precisa de regras de aplicação explícitas para cada destino:
// Regras de aplicação para o spoke de IA
resource fwPolicyRuleCollectionGroup 'Microsoft.Network/firewallPolicies/ruleCollectionGroups@2023-09-01' = {
  name: 'rcg-ia-egress'
  parent: firewallPolicy
  properties: {
    priority: 200
    ruleCollections: [{
      ruleCollectionType: 'FirewallPolicyFilterRuleCollection'
      name: 'rc-ia-services'
      priority: 100
      action: { type: 'Allow' }
      rules: [
        {
          ruleType: 'ApplicationRule'
          name: 'allow-pypi'
          targetFqdns: ['pypi.org', 'files.pythonhosted.org']
          protocols: [{ protocolType: 'Https', port: 443 }]
          sourceAddresses: ['10.1.0.0/16']  // spoke IA
        }
      ]
    }]
  }
}
Segmentação dentro do próprio spoke de IA
Mesmo dentro do spoke, vale segmentar por função com subnets separadas:
VNet Spoke IA (10.1.0.0/16)
├── snet-agents-foundry    (10.1.1.0/24)  ← agentes do Foundry, delegada a Microsoft.App/environments
├── snet-app-integration   (10.1.2.0/26)  ← VNet Integration do App Service, delegada a Microsoft.Web/serverFarms
├── snet-private-endpoints (10.1.3.0/26)  ← PEs de OpenAI, AI Search e Storage
└── snet-aks               (10.1.4.0/22)  ← nós do AKS
Cada serviço de computação fica na sua sub-rede, e não é só organização: a sub-rede dos agentes do Foundry precisa ser delegada a Microsoft.App/environments, exclusiva de um único recurso Foundry, com tamanho recomendado /24. A integração do App Service exige outra delegação. Os dois não cabem na mesma sub-rede, nem com o AKS.
O ganho é controle de NSG. Um NSG na snet-private-endpoints pode bloquear qualquer tráfego que não venha das sub-redes de aplicação, garantindo que só as cargas do domínio acessem os Private Endpoints daquele spoke. Sem essa separação, qualquer recurso dentro da VNet pode chamar o Azure OpenAI ou o AI Search diretamente.
Escala: um hub, múltiplos spokes de IA por domínio de negócio
Conforme a adoção cresce, o padrão recomendado é um spoke de IA por domínio de negócio (RH, Jurídico, Financeiro), cada um com seu próprio Azure AI Search indexando os dados do domínio e seu próprio conjunto de agentes.
A separação vira, na prática, um controle de segurança de dados, não só de infraestrutura. Mas VNets diferentes sozinhas não garantem isso: com tráfego entre spokes passando pelo firewall do hub e zonas de DNS compartilhadas, o spoke de RH consegue alcançar o índice do Jurídico pela rede. O que impede o acesso é a combinação de regra de firewall negando o tráfego entre esses spokes e RBAC no índice que não inclui a identidade dos agentes de RH.
O que fica
Tratar a carga de IA generativa como mais um spoke, e não como uma ilha, é o que permite aplicar a ela a mesma governança, segurança e auditoria que o resto da infraestrutura já tem. O hub não é custo extra: é o que deixa um piloto virar dez squads de IA sem multiplicar firewalls, regras de saída e Private Endpoints duplicados. O componente que mais falha em silêncio nessa topologia é o DNS privado, tema do artigo sobre DNS privado em arquiteturas de IA.
Quantas VNets de IA existem hoje na sua empresa fora do hub, cada uma com a sua própria saída para a internet?