Vi um time subir quatro agentes de IA em produção reaproveitando a mesma Managed Identity. Um fazia triagem de chamado, outro buscava no índice, outro resumia, e o último executava ação em sistema interno. Todos autenticavam com a mesma identidade porque, na hora de entregar, era o caminho mais curto.
Funcionou na primeira semana. O problema apareceu quando alguém da área de risco perguntou o que cada agente tinha acessado no mês anterior.
Ninguém conseguiu responder.
Por que parece que funciona
A decisão de compartilhar identidade quase nunca é preguiça. Ela é consequência de como o projeto nasce.
Você começa com um agente. Cria uma Managed Identity, dá as permissões que ele precisa, funciona. Aí o escopo cresce e aparece o segundo agente. Ele precisa de quase as mesmas coisas, então reaproveitar a identidade existente economiza um dia de trabalho de configuração. O terceiro e o quarto entram pelo mesmo raciocínio.
Em nenhum momento alguém decide “vamos centralizar a identidade”. A centralização acontece por acúmulo de decisões pequenas, cada uma defensável isolada, e o resultado é um desenho que ninguém desenhou.
O que a identidade compartilhada custa
O custo aparece em três lugares, e nenhum deles é performance.
A permissão vira o maior denominador comum
Uma identidade compartilhada precisa ter, somadas, todas as permissões que qualquer um dos agentes precisa. Não existe permissão parcial por chamador dentro de uma mesma identidade.
Na prática, no time que eu descrevi, isso significava que o agente de resumo, que só precisava ler documento, carregava também a permissão de escrita que só o agente de ação usava. Ele nunca escreveu nada. Mas podia.
Esse é o ponto que costuma ser subestimado. Segurança em arquitetura de agentes não é só sobre o que o agente faz, é sobre o que ele consegue fazer se for induzido a isso. Um agente que recebe entrada de usuário é uma superfície de prompt injection, e a pergunta que importa não é se ele vai ser manipulado, é o que ele tem na mão quando for.
O log perde o dono
O Entra ID registra o sign-in da identidade que fez a chamada. Ele não sabe, e não tem como saber, qual dos quatro processos da sua aplicação decidiu fazer aquela chamada.
Quando você abre o log e vê uma leitura fora do padrão, você tem o horário, o recurso acessado e o principal ID da identidade. Isso aponta para os quatro agentes ao mesmo tempo. Você fica com quatro suspeitos e nenhum culpado, e a única saída é correlacionar na mão o log da aplicação com o log da plataforma, torcendo para que o timestamp bata.
Para quem trabalha com auditoria, esse é o tipo de lacuna que não se resolve depois. Ou o rastro existe no momento em que o evento acontece, ou ele não existe.
O raio de alcance de um incidente
Se um agente for comprometido ou induzido a sair do escopo, ele não está limitado ao próprio escopo. Ele está limitado à união dos escopos de todos.
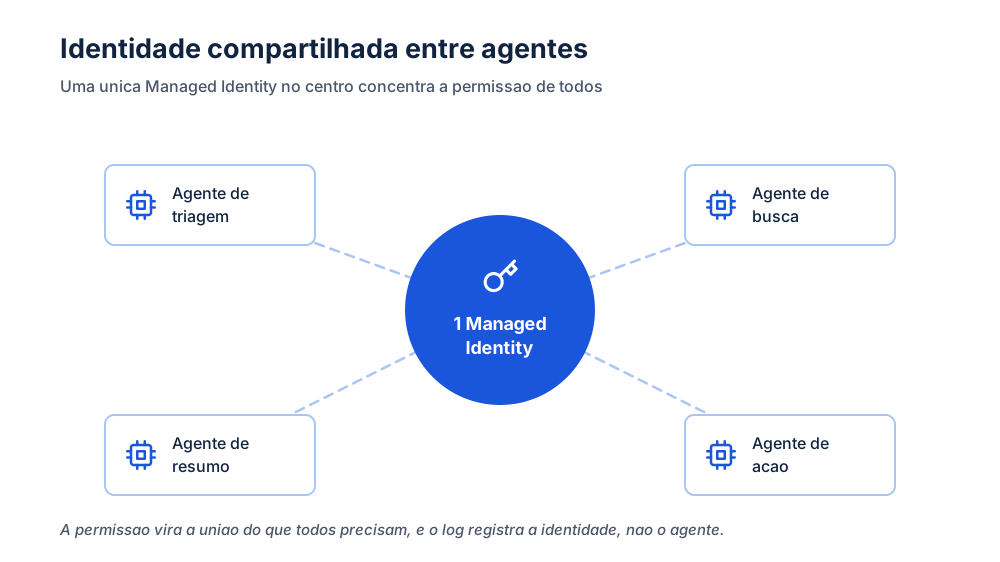
O desenho acima é o que eu encontro com mais frequência em projeto multiagente que cresceu rápido. A identidade no centro parece organização. Ela é, na verdade, um ponto único de confiança: quem chegar nela chega em tudo que ela alcança.
Uma identidade por agente
O desenho que resolve não é complicado, e é por isso que vale a pena fazer certo desde o começo.
Cada agente recebe a própria identidade, criada junto com ele e com permissão só para o que ele faz.
Aqui vale a distinção entre os dois tipos. A system-assigned managed identity nasce e morre junto com o recurso que a hospeda. A user-assigned managed identity é um recurso independente, que você cria, nomeia e associa a quem precisar.
Para arquitetura multiagente, user-assigned costuma ser a escolha certa por três motivos práticos: você consegue criar a identidade antes do agente existir e já atribuir as permissões, consegue nomear de forma que o nome diga qual agente é, e consegue recriar ou mover o agente sem perder o mapa de permissões que já estava validado.
O nome importa mais do que parece. Uma identidade chamada id-agente-triagem-prd transforma o log do Entra ID em algo legível sem consulta a tabela auxiliar. Quando o incidente acontecer, quem estiver olhando o log às duas da manhã vai agradecer.
RBAC no menor escopo que resolve
Identidade dedicada sem escopo correto resolve metade do problema. A outra metade é onde você atribui o papel.
O RBAC do Azure herda de cima para baixo: management group, subscription, resource group, recurso. Atribuir no resource group é confortável porque cobre tudo que está lá dentro, inclusive o que ainda não foi criado. É exatamente por isso que é arriscado.
Na prática, para os agentes do exemplo:
O agente de busca precisa ler o índice do Azure AI Search. O papel Search Index Data Reader, atribuído no serviço de busca, resolve. Ele não precisa de Search Service Contributor, que permitiria mexer na definição do índice.
O agente que chama o modelo precisa de Cognitive Services OpenAI User no recurso do Azure OpenAI. Esse papel dá inferência, não dá gerenciamento de deployment.
O agente que lê documento precisa de Storage Blob Data Reader, e de preferência no container específico, não na conta de armazenamento inteira.
A regra que eu uso para revisar isso é simples: se o papel atribuído permite alguma operação que o agente nunca vai executar no fluxo dele, o papel está largo demais.
O que a identidade dedicada devolve
Além da redução de permissão, você ganha uma coisa que não tinha antes: o log passa a responder sozinho.
Uma chamada anômala aparece com a identidade do agente de resumo, e você já sabe que foi o agente de resumo. Sem correlação manual, sem depender de o log da aplicação estar com o nível certo, sem torcer para o timestamp bater.
A segunda camada que muita gente pula
Aqui está o erro conceitual que eu vejo com mais frequência, inclusive em arquitetura bem feita do lado de identidade.
Identidade e rede respondem perguntas diferentes.
Identidade responde quem. O agente prova que é ele, e o RBAC define o que ele pode tocar.
Rede responde de onde. Private Endpoint, Private DNS e NSG definem de quais caminhos aquele recurso aceita conversa.
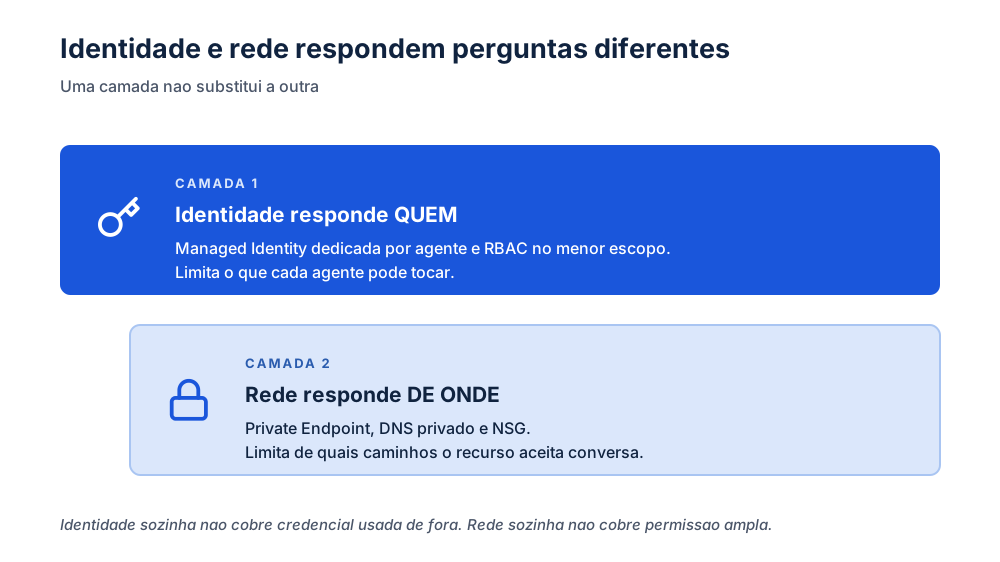
A razão de as duas existirem fica clara quando você pensa no que cada uma não cobre.
Identidade sozinha não protege contra credencial ou token usado de fora do ambiente. Se o endpoint do seu Azure OpenAI aceita tráfego da internet, qualquer um que consiga um token válido fala com ele de qualquer lugar do mundo. O RBAC vai limitar o que essa pessoa faz, mas ela já está dentro da conversa.
Rede sozinha não protege contra permissão ampla. Uma VNet bem fechada com um agente que tem Contributor no resource group continua sendo um agente com Contributor no resource group. Você só reduziu de onde o estrago pode partir, não o tamanho dele.
Na prática, a configuração que fecha as duas pontas é:
Private Endpoint no Azure OpenAI e no Azure AI Search, com as zonas privadas de DNS correspondentes (privatelink.openai.azure.com e privatelink.search.windows.net) resolvendo dentro da VNet.
Acesso público desabilitado nos recursos, para que o endpoint privado seja o único caminho.
Autenticação local desabilitada onde o serviço permite, forçando Entra ID em vez de chave de API. Chave de API é o oposto de identidade por agente: ela é um segredo compartilhável que não carrega quem está usando.
NSG limitando a sub-rede dos agentes ao que ela realmente precisa alcançar.
Vale registrar um detalhe que costuma gerar expectativa errada: Conditional Access foi desenhado para identidade de usuário. Aplicar política condicional a identidade de carga de trabalho exige Microsoft Entra Workload ID, que é licenciamento à parte. Se o seu plano de segurança assume que o Conditional Access vai cobrir os agentes por padrão, confirme isso antes de desenhar em cima.
Dois erros que eu vejo sempre
Dar Contributor no resource group porque é mais rápido. Quase sempre isso acontece na véspera de uma entrega, com a intenção de ajustar depois. O ajuste raramente vem, porque depois que está funcionando ninguém quer mexer. E o agente, na esmagadora maioria dos casos, não precisa criar recurso nenhum. Ele precisa ler um índice e chamar um modelo.
Achar que Private Endpoint dispensa RBAC. É o raciocínio de que, se só quem está dentro da rede alcança o recurso, o que está dentro da rede pode ser confiado. Isso é o modelo de perímetro, e ele já falhou o suficiente para não precisar de mais prova. Rede fechada com permissão ampla continua sendo permissão ampla, só que com menos testemunhas.
O que fica
Identidade compartilhada entre agentes não é atalho de arquitetura. É dívida de auditoria, e ela vence no pior dia possível, que é o dia em que alguém precisa de uma resposta rápida e o seu log não tem.
O trabalho de separar identidade por agente custa algumas horas na fase de desenho e vira quase zero depois que está no template de infraestrutura. Refazer isso com quatro agentes em produção, com permissões acumuladas que ninguém lembra por que foram dadas, custa muito mais.
Se um dos seus agentes fizesse uma chamada indevida hoje, em quanto tempo você saberia qual foi?