Um time me perguntou essa semana quantos agentes eles precisavam para automatizar um fluxo de triagem de chamados. A resposta que eu dei não foi um número. Foi outra pergunta: quem vai ser responsável quando um desses agentes responder errado?
Isso incomoda quem está acostumado a pensar em arquitetura como catálogo de peças. Multiagente virou um dos termos mais usados em IA generativa em 2026, e boa parte dos projetos que vejo começar assim, decidindo quantos agentes construir antes de decidir quem decide o quê, entra em produção com um problema de governança que ninguém desenhou de propósito.
Um agente com boas ferramentas ainda resolve a maioria dos casos
Antes de falar de orquestração, vale a pena dizer o que multiagente não é: não é a resposta padrão para qualquer sistema de IA que faça mais de uma coisa. Um agente único, bem configurado, com acesso a ferramentas certas (busca, function calling, um banco de dados), já cobre grande parte dos casos de uso que aparecem em times de produto.
A divisão em múltiplos agentes começa a fazer sentido quando aparece pelo menos um destes quatro sinais:
- Domínios incompatíveis. Um agente que responde sobre política de reembolso e outro que responde sobre configuração técnica de rede precisam de contexto, tom e fontes de dados tão diferentes que forçar os dois num único prompt degrada a qualidade dos dois.
- Permissões distintas por etapa. Se uma etapa do fluxo precisa acessar um sistema financeiro e outra só precisa ler uma base de conhecimento pública, misturar isso num agente só significa dar a ele o maior escopo de permissão que qualquer etapa individual exige. Isso é o oposto de princípio de menor privilégio.
- Paralelismo que realmente importa. Quando duas etapas são independentes entre si e a soma dos tempos de execução afeta a experiência do usuário, rodar em paralelo corta a latência total. Isso só vale a complexidade extra quando o ganho de tempo é sentido de verdade.
- Auditoria por responsável. Em ambientes regulados (e trabalhando num banco, isso aparece toda semana), cada decisão relevante precisa ser rastreável a um agente e a uma etapa específicos, não a um bloco monolítico de raciocínio.
Se nenhum desses quatro pontos aparece no seu caso, multiagente provavelmente vai adicionar custo e superfície de falha sem entregar qualidade equivalente.
O orquestrador é a peça que decide, não a que sabe tudo
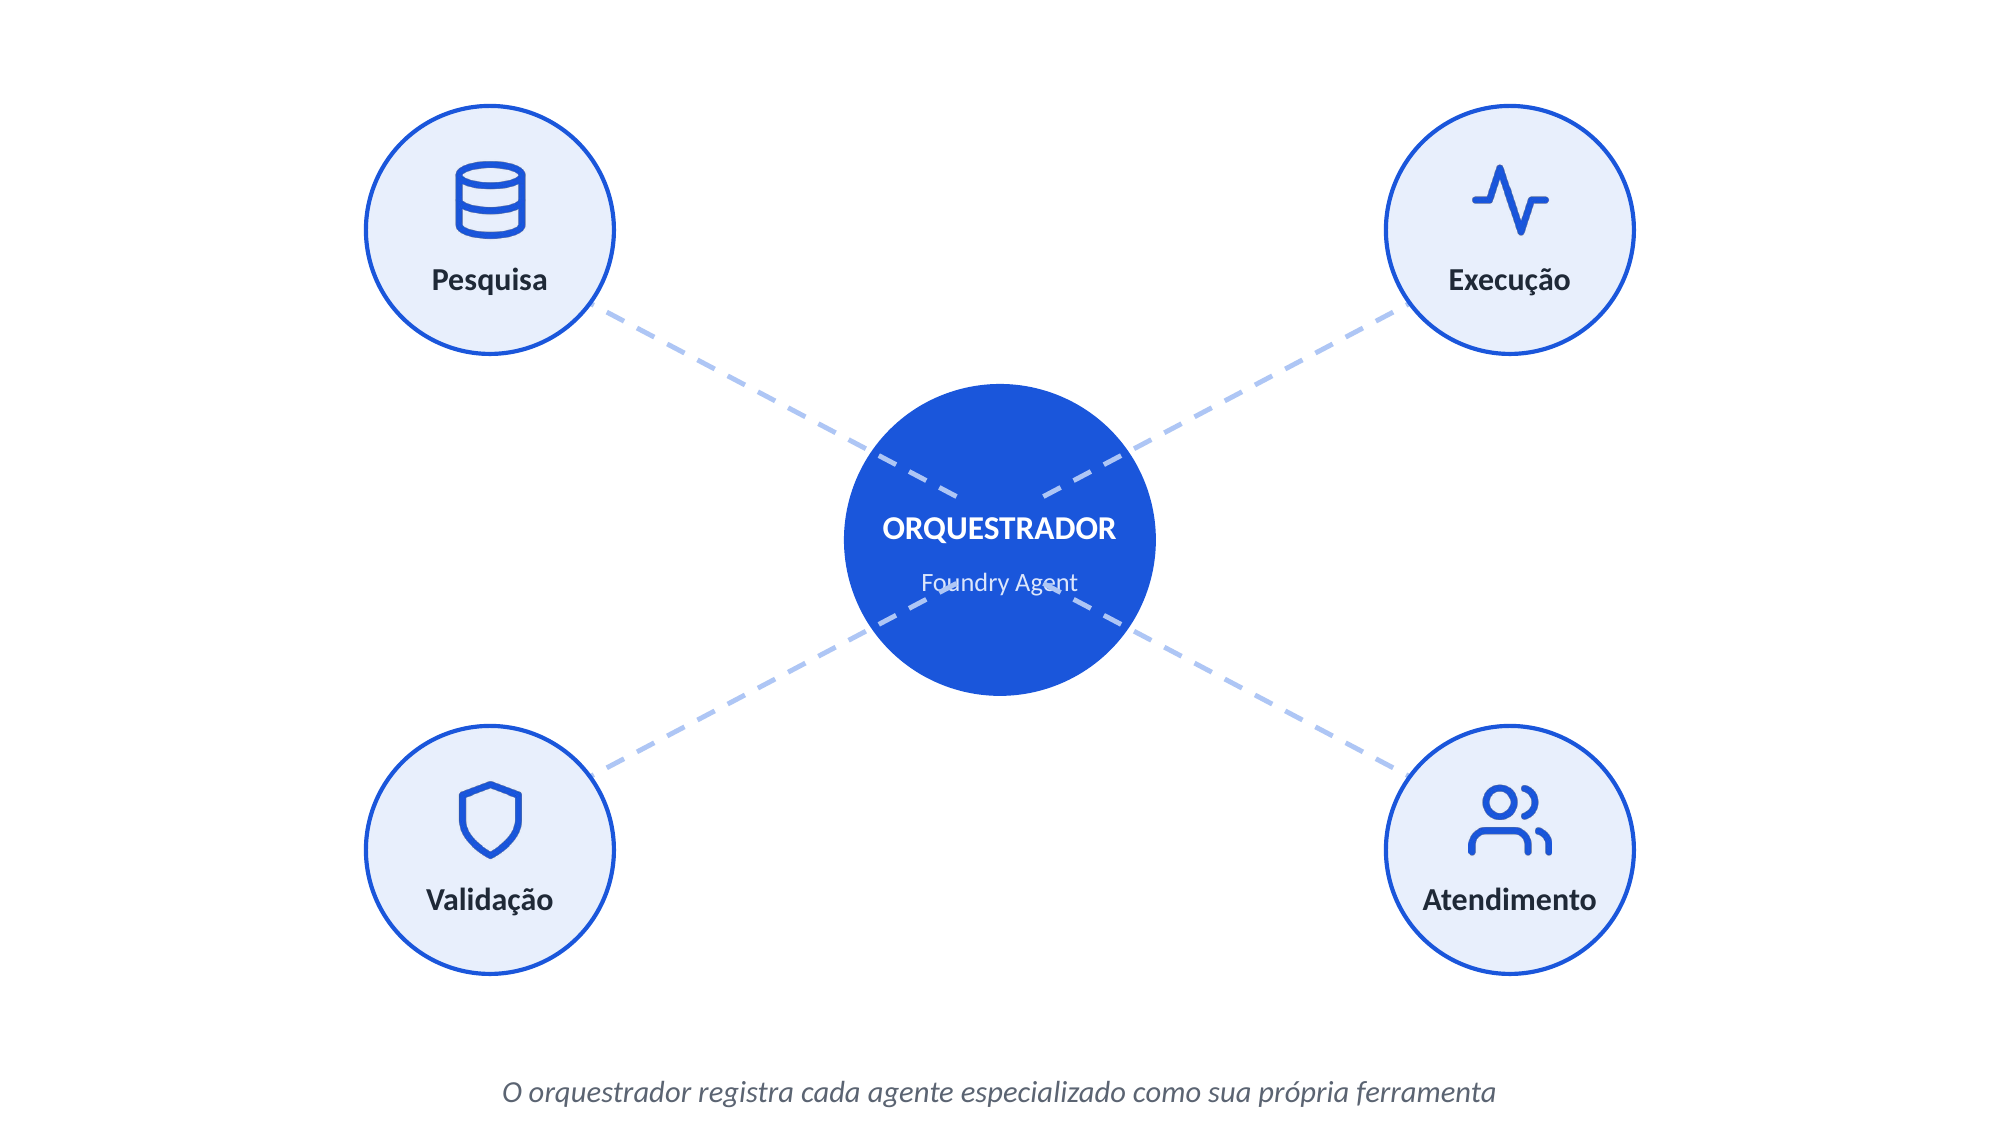
No Microsoft Foundry, o jeito de fazer isso mudou. Os agentes conectados, em que você registrava agentes especializados como ferramentas do agente principal, existem só no Foundry clássico, em preview, e não são suportados no Agent Service atual. O caminho recomendado hoje é a ferramenta A2A (agent-to-agent), que é GA: o agente principal chama os especializados como ferramentas, pelo protocolo aberto A2A. Para orquestração escrita em código, a peça é o Microsoft Agent Framework. A ideia de fundo não mudou: o orquestrador não precisa saber como cada agente executa sua tarefa. Ele precisa saber quando chamar cada um.
Isso parece um detalhe pequeno, mas muda o design inteiro. Um erro comum é tratar o orquestrador como um agente “mais inteligente” que os outros, quando na prática ele é o agente com o prompt de sistema mais crítico do fluxo inteiro. Se ele classifica errado a intenção do usuário e chama o agente de suporte técnico para uma pergunta financeira, o agente errado vai produzir uma resposta coerente e completamente inútil, porque o problema não estava na execução, estava no roteamento.
Isso tem uma implicação prática direta: a qualidade do prompt do orquestrador determina a precisão do sistema inteiro, muito mais do que a qualidade dos prompts dos agentes especializados. Vale gastar mais tempo de teste ali do que em qualquer outro componente.
As camadas que ninguém pode pular
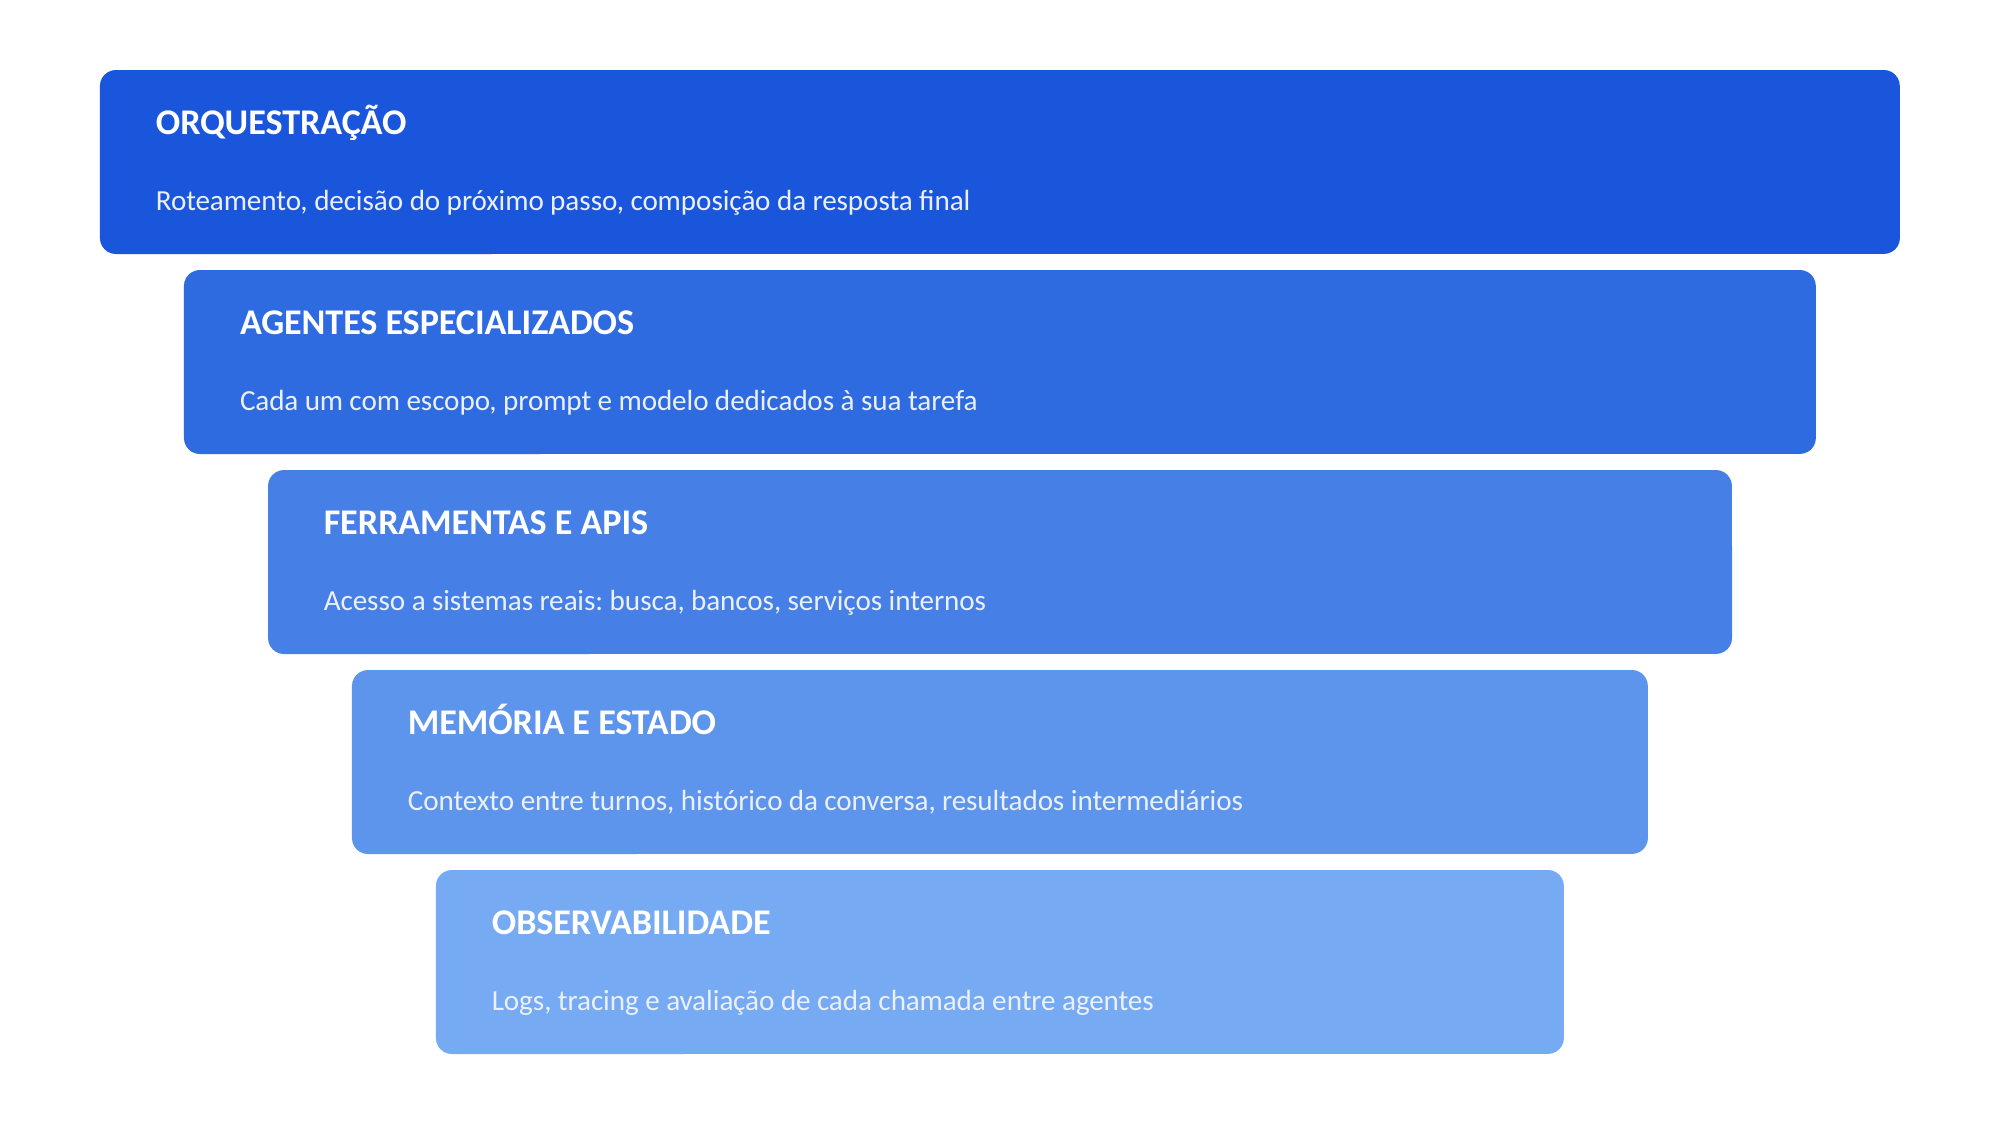
Um sistema multiagente em produção tem responsabilidades que não aparecem no protótipo de laboratório e que custam caro quando são adicionadas depois:
- Orquestração: decide o próximo passo e compõe a resposta final.
- Agentes especializados: cada um com escopo, prompt e, quando fizer sentido, modelo próprios.
- Ferramentas e APIs: o ponto onde o sistema toca dados e sistemas reais.
- Memória e estado: contexto entre turnos, histórico e resultados intermediários que precisam sobreviver entre chamadas.
- Observabilidade: logs e tracing de cada chamada entre agentes, porque depurar “por que o sistema respondeu isso” sem rastro por etapa é praticamente impossível em um fluxo com mais de dois agentes.
A camada de observabilidade costuma ser a primeira a ficar de fora do escopo inicial e a primeira a faltar no primeiro incidente sério.
Checklist antes de colocar em produção
Antes de assinar embaixo de um sistema multiagente:
- Papel e escopo de cada agente documentados, não apenas implementados.
- Orquestrador testado contra intents ambíguos, não só contra os exemplos óbvios.
- Fallback definido para quando um agente falha ou responde fora do esperado.
- Permissões e identidade isoladas por agente, seguindo o mesmo princípio que você já aplica a serviços.
- Auditoria e trace ponta a ponta habilitados desde o primeiro deploy, não como item de backlog.
- Testes de regressão cobrindo os fluxos críticos, porque cada ajuste de prompt em um agente pode mudar o comportamento de roteamento do orquestrador.
- Limite de custo e de chamadas por conversa, porque multiagente multiplica chamadas de modelo por natureza.
Nenhum desses itens é sofisticado. Todos são esquecidos quando o projeto sai do protótipo direto para a demonstração ao cliente.
Orquestração de múltiplos agentes não é sobre quantos agentes você consegue colocar para conversar entre si. É sobre ter clareza de papel: quem decide, quem executa, quem responde quando algo dá errado. Se essa resposta não está clara no seu desenho hoje, o número de agentes é a menor das suas preocupações.